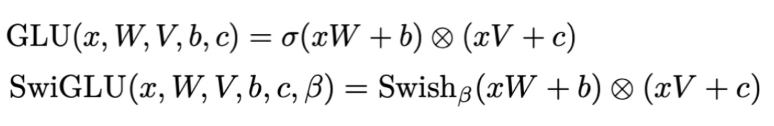
참고: Swish 란
Swish와 SwiGLU는 서로 다른 개념임.
Swish는 하나의 activation function임:
$$
\operatorname{Swish}(x)
=
x\sigma(x)
$$
- 여기서 $\sigma(x)$는 sigmoid 함수임.
- 즉, 입력 $x$에 sigmoid를 곱하여 입력의 크기를 조절하는 형태의 activation function임.
https://dsaint31.me/mkdocs_site/ML/ch09/act_silu/
BME
activation function deep learning gelu glu mish relu silu swish Sigmoid Linear Unit (SiLU) : from GELU to MiSH SiLU 는 Sigmoid Linear Unit 의 약자로 ELU (2015) 이후 2016년에 등장한 smooth activation function 계열 중 하나로, 여러 실험
dsaint31.me
SwiGLU 란
SwiGLU는 GLU(Gated Linear Unit) 계열의 gated activation 구조임.
대표적인 형태는 다음과 같음:
$$
\operatorname{SwiGLU}(x)
=
\operatorname{Swish}(xW_1)
\odot
(xW_2)
$$
- $W_1$과 $W_2$는 서로 다른 weight matrix임.
- $\odot$는 element-wise multiplication을 의미함.
즉,
- 입력 $x$를 두 개의 linear projection으로 나눈 후, 한쪽에는 Swish를 적용하고 다른 한쪽을 gate로 사용함.
- 그 다음 두 결과를 element-wise multiplication함.
SwiGLU를 Swish의 정의까지 포함하여 전개하면 다음과 같음:
$$
\operatorname{SwiGLU}(x)
=
\left[
(xW_1)\sigma(xW_1)
\right]
\odot
(xW_2)
$$
따라서 SwiGLU는 단순한 activation function이 아니라 두 개의 projection 경로와 gating을 결합한 구조임.
Gate의 역할
Gate는 정보의 통과 정도를 조절하는 역할을 함.
직관적으로는 밸브(valve) 또는 조절기와 같이 생각할 수 있음.
어떤 정보 $h$와 gate $g$가 있을 경우 다음과 같이 표현할 수 있음:
$$
\operatorname{output}
=
h\odot g
$$
따라서 gate의 값에 따라 각 feature의 영향이 달라짐.
- $g$가 작음 : 해당 feature의 영향을 억제함.
- $g$가 큼 : 해당 feature의 영향을 크게 반영함.
- $g$의 부호가 음수인 경우 : 해당 feature의 방향까지 반전시킬 수 있음.
여기서 중요한 점은
- SwiGLU의 gate가 sigmoid를 통과한 값으로 제한되는 것은 아니라는 것임.
- SwiGLU에서는 다음과 같이 두 번째 linear projection의 결과가 gate 역할을 함:
$$
g=xW_2
$$
따라서 gate의 값이 반드시 $0\sim1$ 사이에 있을 필요는 없음.
즉, SwiGLU의 gate는
- 단순히 정보를 켜고 끄는 역할보다는
- 각 feature의 정보를 학습적으로 조절하는 역할을 수행함.
SwiGLU의 전체 구조
입력 (x)가 들어오면 두 개의 경로로 분리됨.
첫 번째 경로는 linear projection 후 Swish를 적용함:
$$
h
=
\operatorname{Swish}(xW_1)
$$
두 번째 경로는 linear projection만 수행하고 gate로 사용함:
$$
g
=
xW_2
$$
그 다음 두 결과를 element-wise multiplication함:
$$
\operatorname{SwiGLU}(x)
=
h\odot g
$$
따라서 SwiGLU에서는
- 단순히 activation function을 적용하는 것뿐만 아니라,
- 다른 경로에서 생성된 gate를 이용하여 각 feature의 정보를 조절함.
Transformer FFN에서의 SwiGLU
Transformer의 FFN에서는 SwiGLU의 결과에 다시 output projection을 적용함.
개념적으로 다음과 같이 표현할 수 있음:
$$
\operatorname{FFN}(x)
=
\operatorname{SwiGLU}(x)W_3
$$
이를 전체적으로 표현하면 다음과 같음:
$$
\boxed{
\operatorname{FFN}(x)
=
\left[
\operatorname{Swish}(xW_1)
\odot
(xW_2)
\right]W_3
}
$$
- $W_1$과 $W_2$는 각각 activation branch와 gate branch를 생성하고,
- $W_3$는 두 branch의 element-wise multiplication 결과를 다시 출력 공간으로 projection하는 역할을 함.
Swish vs. SwiGLU
| Swish | SwiGLU | |
| 종류 | Activation function | Gated activation 구조 |
| 기본 형태 | $x\sigma(x)$ | Swish + gate |
| Linear projection | 하나 | 두 개 |
| 핵심 연산 | activation | gating + element-wise multiplication |
| Gate | 없음 | 있음 |
| 관계 | 독립적인 activation function | Swish를 사용하는 GLU 변형 |
- Swish는 하나의 activation function이고,
- SwiGLU는 Swish를 포함하면서 별도의 gate를 이용하여 정보를 조절하는 GLU 계열의 구조 임.
- SwiGLU에서 Swi는 Swish에서 유래한 이름임.
'Programming > ML' 카테고리의 다른 글
| 최소제곱 손실함수의 gradient 유도 (0) | 2026.09.08 |
|---|---|
| Forward-Mode Automatic Differentiation (0) | 2026.09.02 |
| Empirical risk (0) | 2026.08.12 |
| Monte Carlo와 MCMC (0) | 2026.08.02 |
| DropPath 와 Stochastic Depth (0) | 2026.07.10 |